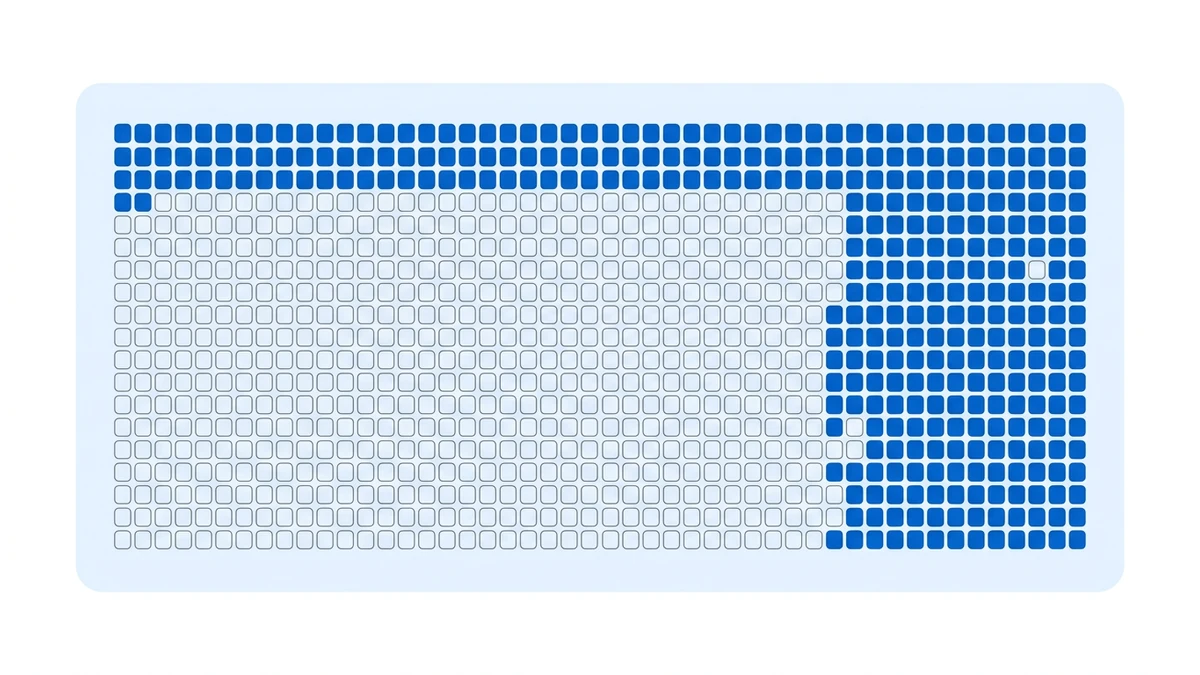
判断一份资金费率数据能回答什么问题,先看三件事:每个标的从哪天开始有数据,中间缺了哪些期,每一年参与统计的标的有几个。总记录数反而最不重要。我们自己的库就是例子:截至 2026-10-08,共 1,029,262 期结算、覆盖 534 个交易对,但 2020 到 2024 年,每年都只有 BTCUSDT 和 ETHUSDT 两个标的。
接口请求成功不等于数据完整,这一点在币本位采集复盘里讲过。这一篇往下走一层:数据进库以后,怎么判断它撑得起哪些结论。
样本构成一变,平均值就跟着变
| 年份 | 标的数 | 结算期数 | 为正占比 | 每期平均 |
|---|---|---|---|---|
| 2020 | 2 | 2,194 | 91.52% | +0.0204% |
| 2021 | 2 | 2,190 | 94.29% | +0.0311% |
| 2022 | 2 | 2,190 | 71.87% | +0.0023% |
| 2023 | 2 | 2,190 | 90.37% | +0.0073% |
| 2024 | 2 | 2,196 | 93.72% | +0.0114% |
| 2025 | 460 | 300,090 | 68.59% | −0.0071% |
| 2026(至 10-08) | 534 | 718,212 | 75.63% | −0.0052% |
只看最后一列,会得出「2025 年起资金费率整体转负」的结论。但同一张表的第二列说明了另一件事:标的从 2 个变成了 460 个。新增的几百个小币把平均值拉了下去,市场本身未必变了。只看两个有长历史的标的,BTCUSDT 自 2020 年以来 85.95% 的期为正,ETHUSDT 是 86.22%。
跨年比较必须用两年都有的那批标的。 用扩容后的全市场数据直接和扩容前比,比的其实是两个不同的样本。
体检清单:每一项都写成计数,而不是「正常」
- 市场范围。 采的是哪个市场、哪种合约,接口是否适用。我们踩过的坑:19 个币本位合约被交给了只认 U 本位合约的费率接口,接口返回空页、却仍报成功;于是它们每 15 分钟「开始采」一次,一行都没进库,日志里只有那句「本轮开始采」。
- 结果计数。 分别记候选数、范围外排除数、请求成功数、返回记录数、实际写入数,以及各标的最新一期的结算时间。这几个数单位不同,不能相加。
- 覆盖矩阵。 每个标的一行:首期、末期、实际期数、按周期应有的期数、已知缺口。合约存在六年,不代表你的库采了六年。
- 来源一致性。 同一个格子在不同来源里要对得上,对不上就两个都留、都标出处。我们自己就有一处:站点逐年业绩表里,2020 年的期数标为「不明」(那一格是旧看板留下的累计值,无法逐期核对);而全市场统计表里,2020 年记了 2,194 期。我们没有挑一个删掉另一个,而是在页面上把这个瑕疵摆出来。
- 统计口径和展示口径。 近 30 天统计纳入了 529 个合约,其中 4 个代码为非 ASCII 字符的合约计入总数、但不进榜单。差额要写在页面上,否则有人按榜单去核总数,会对不上。
- 下架合约及时出名单。 下架后还留在名单里的合约,每一轮都会报错,而且永远不会好。我们有过三条同样的错误连续刷了三周的记录。
判读规则
- 讲多年趋势,只能用有多年历史的标的。我们库里撑得起「逐年」叙述的只有 BTCUSDT 和 ETHUSDT。
- 讲「今年比去年」,先把样本固定成两年都有数据的那批合约。
- 每个数字都带截止时间。数据最新到快照那一刻,不是读者打开页面的那一刻。
- 拿不准一个缺口是「市场没有结算」还是「我们没采到」,就写「未知」,不要填零。
逐年业绩怎么在这些限制下展示,见六年复盘和业绩页;全市场分布见把 450 张合约今年的资金费率各自相加;实时数字见资金费率数据页。数据检查提高的是结论的可解释性,不消除交易风险。